
学习资料:提示工程指南
1、模型设置
- Temperature:值越小,结果越准确;反之,更具有想象力。
- Top_p:和Temperature一样的效果。
- Max Length:大模型生成的Token数。(Token太长,容易冗余且成本高)
- Stop Sequences:阻止模型生成 token。类似于Max Length。
- Frequency Penalty:对下一个生成的 token 进行惩罚,和重复次数成正比。
- Presence Penalty:对所有重复的 token 进行相同的惩罚。设置越高,重复词越少,内容更丰富;反之,越专注。
temperature和top_p,frequency penalty和presence penalty,只需要调整其中一个参数就行,不要同时调整两个。
2、提示词
要素
指令、上下文、输入数据、输出指示:输出的格式或类型
技巧
具体、准确、提供正向执行
技术
- 零样本提示(zero-shot prompting)
- 少样本提示
- 链式思考(CoT)提示

- 零样本 COT 提示:
让我们逐步思考

- 自动思维链(Auto-CoT)

-
自我一致性:通过少样本 CoT 采样多个不同的推理路径,并使用生成结果选择最一致的答案。
-
生成知识提示:
问题,知识,解释和答案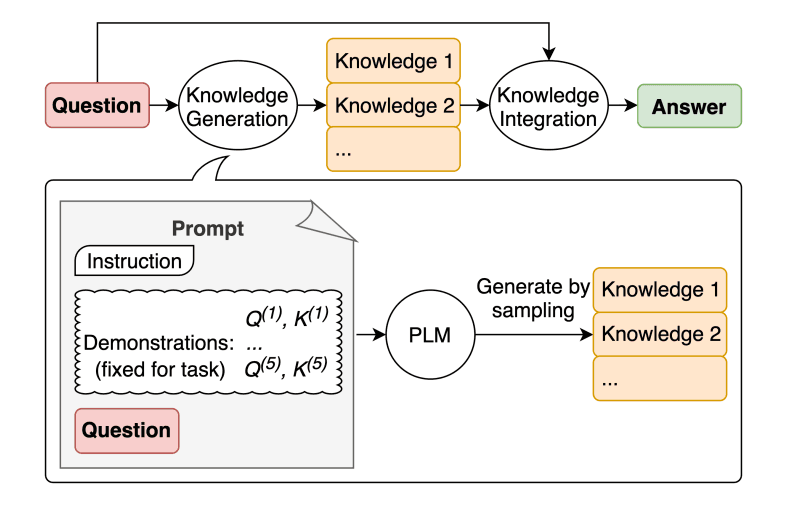
-
链式提示(prompt chaining):将任务分解为许多子任务。 确定子任务后,将子任务的提示词提供给语言模型,得到的结果作为新的提示词的一部分。